
Strata:面向长上下文语言模型服务的分层上下文缓存
Strata:面向长上下文语言模型服务的分层上下文缓存
Background
长上下文 LLM 推理
LLM 推理分预填充和解码两阶段。预填充同时处理用户查询新 token 与上下文 token,产出 KV 缓存,使后续 token 无需重算即可关注历史。解码阶段自回归生成 token,持续复用并扩展 KV 缓存。长上下文会放大两阶段成本:更长前缀增加预填充延迟,缓存被驱逐或不可用时重算代价更高;解码时 KV 缓存随序列长度线性增长,内存占用与数据移动可能成为主要瓶颈,因此高效的缓存复用、放置和驱逐对高吞吐、低延迟服务至关重要。
KVCache 的内存管理
PagedAttention通过使用动态的、基于页的分配方式,避免为 KV 缓存预留大的连续块,缓存被划分为多个固定大小的小页面,这些页面保持逻辑顺序,但在内存中可以非连续放置,从而提高利用率。典型的页面大小很小,TensorRT‑LLM 、 vLLM 和 SGLang 中分别为 32 、 16 和 1 个 token, 而单个 token 的 KV 状态可能跨越数千字节到数兆字节。虽然这种细粒度对计算内核来说是可管理的,但它对跨内存层级的数据移动带来了效率挑战
LLM 服务中的上下文缓存
除了请求内复用之外,系统还通过使用前缀树或哈希映射 等结构识别公共前缀,从而在请求之间利用上下文缓存。为扩展容量,缓存被存储在较慢的层级中,如 CPU 内存、分布式内存池, 甚至磁盘。
Observation
KV 缓存传输中的低带宽利用率
根据利特尔法则,我们得到:最大化数据吞吐量=高并发性✖️大传输尺寸➗低延迟。
对于并发性,虽然可以通过启动大量异步 I/O 操作来增加并发性,但实际限制来自可用的应用级并行性(例如,在 CPU 上)以及 GPU 驱动程序 (例如,CUDA 驱动程序)和硬件内的队列容量 。
对于延迟,在 CPU 和 GPU 内存之间传输数据,通常使用诸如 cudaMemcpyAsync 之类的异步操作来启用 GPU 的直接内存访问( DMA )引擎。然而,此场景中的延迟包含不可忽略的 CPU‑GPU 通信开销和调度延迟。
由此看来,并发性和延迟都是有优化限制的,增加传输尺寸才是提高带宽利用率最实用的手段。
增大页面大小是一种增加传输尺寸的方案,但是它会给 LLM 推理带来显 著的性能损失:
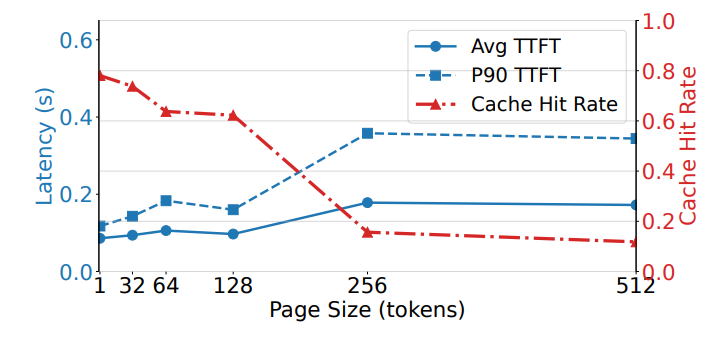
增大页面大小会导致 KV 缓存命中率显著下降。这种退化直接导致 TTFT 大幅增加。这种对小页面的偏好导致 KV 缓存操作的有效传输大小非常小,从而导致 I/O 带宽严重利用不足。
资源编排与延迟命中
资源编排:现有工作要么认为从 CPU 到 GPU 的 KV 缓存加 载可以忽略不计,假设通过 PCIe 加载第 N +1 层缓存数据的延迟可以通过将 I/O 与第 N 层的计算重叠来有效隐藏,要么在成本合理时选择重新计算,当服务具有长缓存上下文但需要预填充的新 token 相对较少的请求时,这一假设便不再成立。一方面,批量 KV 缓存传输的延迟可能超过层级计算所能隐藏的程度;另一方面,随着上下文长度增长,重新计算的成本越来越高,使其成为一种不具吸引力的替代方案。 因此,逐层重叠的预填充可能退化为受 PCIe 带宽限制的任务。
延迟命中:当针对同一数据对象的多个请求在 初始缓存未命中仍在解决时到达,后续请求实际上被当作缓存未命中处理,尽管如果第一个请求已完成,它们本应是缓存命中
design
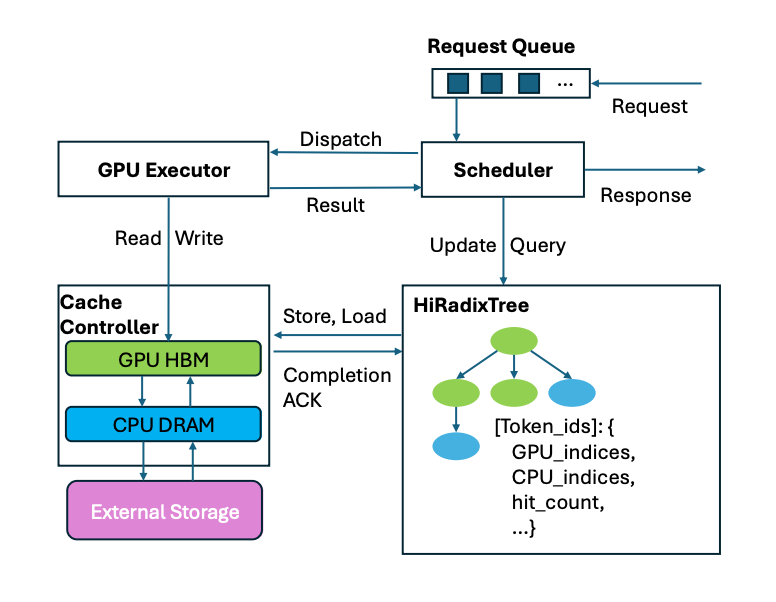
Strata 缓存控制器
为了解决KV 缓存传输中的带宽利用率低的问题,Strata 利用 GPU 辅助 I/O 在 CPU 和 GPU 内存之间传输 KV 缓存页,从而对小而碎片化的数据实现低延迟 I/O。具体而言,GPU 辅助 I/O 作业不是通过反复调用标准的 cudaMemcpyAsync API 来进行小数据传输,而是通过启动一个 CUDA 内核来运行。该内核会生成数千个线程。每个线程负责从源( GPU 全局内存或 CPU 注册的固定内存)加载一小块数据到其本地寄存器文件中,然后将此数据流式传输到目标( GPU 全局内存或注册的 CPU 固定内存)。
GPU 辅助 I/O具有:增强并发性、兼容小传输、允许灵活的内存布局等优势。
当涉及外部存储时,缓存控制器会在存储层检测到缓存命中时,机会性地将数据从存储预取到主机内存中。预取延迟与请求的排队延迟重叠。一旦调度器选择该请求执行,缓存控制器会终止任何正在进行的预取,并使用 主机或 GPU 内存中已有的缓存。这种默认的尽力而为策略的动机在于,存储层相对于主机 ‑GPU 传输的延迟显著更高且更难以预测
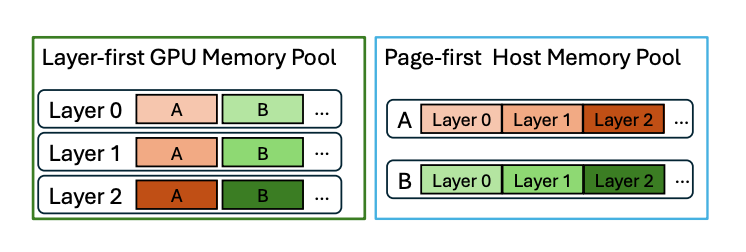
Strata通过实现计算友好与传输友好布局之间几乎零开销的即时转换,使得GPU 可以保持其计算友好的层优先布局,而其他介质 (如主机内存和外部存储)可以采用页优先布局。
Strata 调度器
调度器通过三个阶段实现通过避免延迟命中和加载停顿来最大化缓存收益。
延迟命中时的推迟
延迟命中可能在两种情况下导致冗余计算:
- 当多个共享同一缓存未命中的请求被调度到同一批次中时
- 当请求的执行被异步准备,而未意识到相应的上下文缓存仍在计算中时
Strata在 HiRadixTree 中引入了瞬态节点,它们使用 token ID 作为遍历键,但是它们不指向内存索引,而是携带两种标记之一:in‑queue, 表示某个请求正在引用新的上下文;in‑flight,表示对应 token 的缓存正在计算中。
通过in-queue标记,请求可以识别出来是否有共享同一缓存的情况(情况1),通过in-flight标记,可以防止异步准备的情况。(情况2)
然后使用一个可配置阈值:只有当瞬态节点上的 token 匹配数超过该值时从而选择是等候下一批次还是直接进入同一批次计算。
均衡批次形成
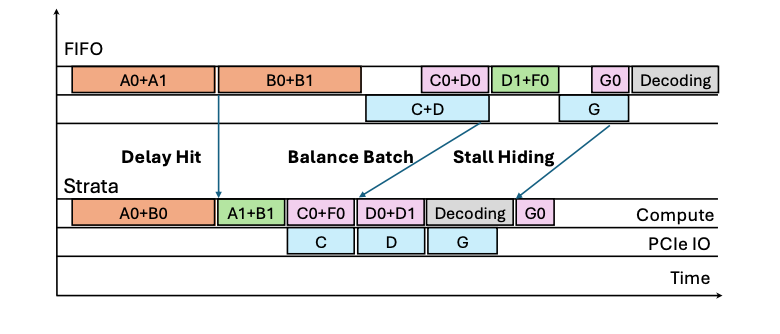
在每个批次形成之前, 调度器使用 HiRadixTree 获取每个请求的负载和计算需求,在批次形成期间,当调度器遍历队列时,它会检查添加请求是否会使批次达到加载受限上限,该上限定义为聚合负载 与计算量的比率。当该比率超过阈值时,批次被视为加载受限。如果请求能够加入批次而不会使批次变为加载受限,则将其加入批次。否则,该请求被移至降优先级列表。
使用气泡填充隐藏加载停顿
将加载停顿与有用计算重叠,如图中的G加载的同时插入了decoding气泡来提高利用率
Evaluation
略
conclusion
Strata通过结合 GPU 辅助 I/O 以缓解 KV 缓存碎片化,以及平衡计算与数据传输的缓存感知调度,Strata 提高了在不同延迟区间下的利用率。