
RMSNorm:均方根层归一化
RMSNorm:均方根层归一化
RMSNorm(Root Mean Square Layer Normalization,均方根层归一化)是一种对特征向量的幅值进行归一化的方法。它与 LayerNorm 一样,通常沿着每个 token 的隐藏维度计算;不同之处在于,RMSNorm 不减去特征均值,只用均方根(RMS)作为缩放因子。
为什么要做归一化?
在深层网络中,信号经过多层变换,激活的尺度可能逐渐变大或变小。反向传播的梯度也会经过多层雅可比矩阵连乘,因此可能出现梯度爆炸或消失。归一化会对中间表示的尺度进行约束,通常能让训练更稳定。
不过,归一化不是直接“修复梯度”的保证。它主要改变每层看到的激活分布和网络的梯度传播性质;效果还取决于网络结构、初始化、学习率等因素。
RMSNorm 的计算方式
设某个 token 的隐藏状态为 $\mathbf{x} \in \mathbb{R}^d$,其均方根为:
RMSNorm 的输出通常写作:
其中,$\epsilon$ 是避免除零并提高数值稳定性的微小常数,$g_i$ 是可学习的逐维缩放参数。原始 RMSNorm 不包含可学习偏置;具体实现可能略有差异。
计算时,每个 token 独立地在隐藏维度上求 RMS,不会跨 batch 中的样本计算统计量。归一化后的数值再乘以可学习参数,因此模型可以学习各个特征维度需要的尺度。
RMSNorm 与 LayerNorm 有什么区别?
LayerNorm 会先减去均值,再除以标准差:
常见实现之间在偏置项、方差定义和数值细节上可能不同。两者的核心区别如下:
| 方法 | 归一化前的处理 | 主要计算 | 常见可学习参数 |
|---|---|---|---|
| LayerNorm | 减均值,再按标准差缩放 | 均值、方差和缩放 | 缩放 $\gamma$ 与偏置 $\beta$ |
| RMSNorm | 不减均值,直接按 RMS 缩放 | 平方、求均值和开方 | 缩放 $g$ |
计算 RMSNorm 时不必先求均值并计算中心化方差,因此通常能减少一些计算。实际速度提升取决于张量形状、硬件和算子实现;两种方法都需要沿特征维度做归约。
为什么许多模型会选择 RMSNorm?
RMSNorm 的提出者认为,在他们研究的设置中,LayerNorm 的重新缩放不变性已经足以带来有效的归一化效果,显式减均值带来的再中心化不变性并非总是必要。RMSNorm 因而保留了更简单的计算路径,并且不会主动把输入的特征均值移到零。
这是一种经验结论,不意味着 RMSNorm 在所有模型和任务上都优于 LayerNorm。是否适用需要结合具体架构和训练结果判断。
几何意义
先忽略 $\epsilon$ 和可学习缩放参数 $g$。RMSNorm 把向量除以自己的 RMS:
所以归一化后的向量位于 $d$ 维空间中半径为 $\sqrt{d}$ 的球面上。直观地看,它保留向量方向,主要调整向量的整体长度。这里说“投影到球面”是指沿径向缩放;加入 $\epsilon$ 后,半径会略小于 $\sqrt{d}$,再乘以逐维的 $g$ 后也不再严格落在这个球面上。
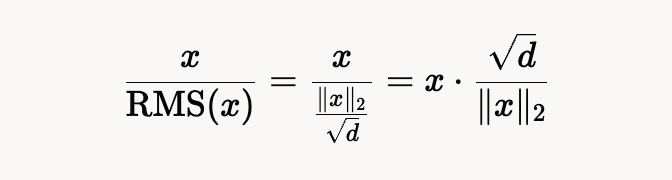
在 Transformer 中怎么用?
在常见的 Pre-Norm Transformer 中,归一化层通常放在注意力子层或前馈子层之前,例如:
这里的 Norm 可以是 LayerNorm,也可以是 RMSNorm。归一化层控制送入子层的隐藏状态尺度,残差连接则提供跨层的信息通路。不同模型的归一化位置和残差结构可能不同。
一个简化的 PyTorch 实现
下面的实现把平方和均值计算提升到 FP32,减少低精度输入下的数值误差;生产环境通常会使用融合算子以减少额外的内存读写。
1 | import torch |
这里假设 weight 的形状为 (hidden_size,),并且归一化维度是最后一维。实际模型还需要根据框架约定处理参数 dtype、张量布局和混合精度。
总结
RMSNorm 可以看作“按均方根缩放,但不减均值”的 LayerNorm 变体。它计算简单,已广泛用于 Transformer 等模型;它是否比 LayerNorm 更合适,则应由目标模型上的训练稳定性、效果和运行效率共同决定。
参考资料
- Biao Zhang, Rico Sennrich, Root Mean Square Layer Normalization, NeurIPS 2019.